存储器概述
存储层次与分类
存储层次结构
存储层次结构
从 CPU 到外部存储器,典型层次为:
越靠近 CPU 的层次速度越快、单位容量成本越高、容量越小。层次结构能够同时获得接近高速层的访问速度和接近低速层的容量与价格。
存储器的分类
存储器的分类
命中率与平均访问时间
命中率与平均访问时间
命中率表示访问落在高速层中的比例:若一次访问命中时耗时 ,未命中时总耗时 ,则平均访问时间为:
表示一次未命中访问的总时间,不一定是“缺失代价”。若题目给出的未命中时间仅为额外开销,应写成 。
局部性原理
- 时间局部性:刚被访问过的数据或指令,在后续访问中很可能再次被访问。循环变量、循环体代码是典型例子。
- 空间局部性:刚被访问过的存储单元,其相邻单元在后续访问中很可能被访问。顺序访问数组、顺序执行指令是典型例子。
Cache 之所以有效,是因为程序同时具有时间局部性和空间局部性。若题目询问“为什么一次调入一个数据块”,应从空间局部性解释。
主存储器
半导体随机存取存储器
SRAM 与 DRAM 的对比
SRAM 与 DRAM 的对比
DRAM 的刷新
DRAM 的刷新
DRAM 用电容保存数据,电荷会因漏电逐渐丢失,因此必须在规定时间内逐行读出并再生,这个过程称为刷新。刷新的关键结论:
- 刷新以行为单位,不需要列地址,也不需要 CAS。
- 刷新一遍所需的操作次数等于 DRAM 的行数。
- RAS-only 刷新由外部提供行地址;自动刷新由片内刷新计数器产生行地址。
- 刷新周期通常指全部存储单元必须完成一次刷新的最大时间,例如某器件规定为 。
存储芯片的组成与 DRAM 示例
存储芯片的组成与 DRAM 示例
DRAM 芯片通常由存储体、地址译码器、I/O 电路、片选控制逻辑和读写控制线组成。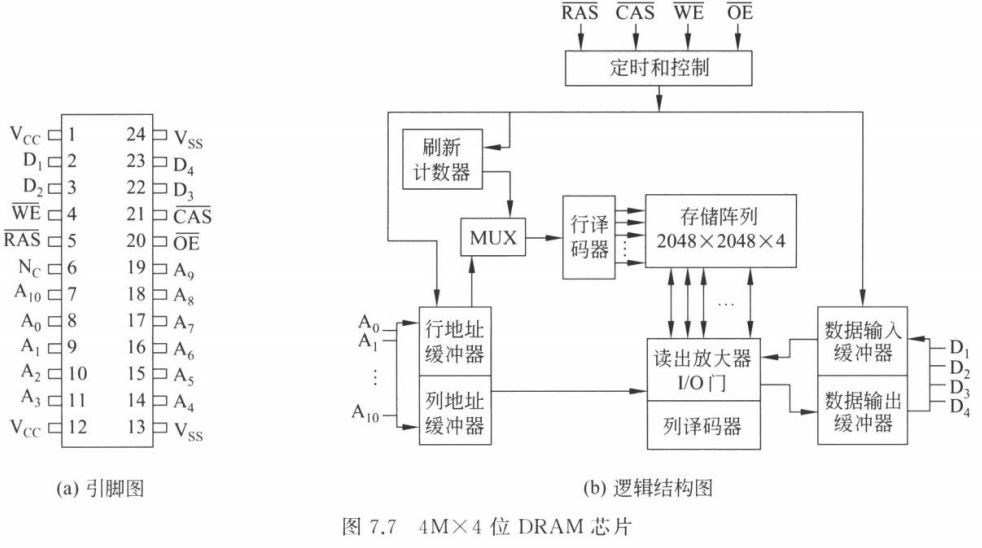
- 芯片有 11 根地址线 和 4 根数据线 。在 RAS 和 CAS 控制下,同一组地址引脚分时传送行地址和列地址。
- 存储阵列为 位,共有 4 个位平面。行地址和列地址各 11 位,同一行、列交叉处的 4 个位平面同时读写。
- 刷新时不需要列寻址。对于 RAS-only 刷新,外部提供行地址;对于自动刷新,片内刷新计数器产生行地址。
- 芯片共有 2048 行,因此将全部存储单元刷新一遍需要 2048 次行刷新。
存储器芯片的扩展
位扩展、字扩展与字位同时扩展
位扩展、字扩展与字位同时扩展
设目标存储器规格为“目标字数 × 目标字长”,单片芯片规格为“单片字数 × 单片字长”。
扩展计算示例
扩展计算示例
用 位的芯片组成 位的主存。
- 位向片数:
- 字向片数:
- 芯片总数:
多模块存储器
连续编址与交叉编址
连续编址与交叉编址
对按字编址的交叉存储器,若共有 个模块,则:
交叉编址示例
轮流启动与同时启动
轮流启动与同时启动
轮流启动方式设模块存取周期为 ,数据总线传送一个字的周期为 。为了避免下一个模块的数据已经准备好时总线仍被占用,模块数应满足:若题目要求最小整数模块数,则应取:连续读取 个字所需时间为:同时启动方式
第一个字需要等待模块完成一次存取,后续 个字可以按总线周期依次传送。
- 多个模块同时开始读或写。
- 所有模块一次并行读写的总位数必须能够由存储器数据总线一次传送。
- 并行访问通常以连续若干字节为单位,并受到数据对齐要求约束。
为什么交叉编址能提高吞吐率
为什么交叉编址能提高吞吐率
连续编址时,连续地址集中在同一模块,CPU 顺序读取时仍需等待该模块完成一次存取,其他模块无法有效接续工作。交叉编址时,连续地址分散在不同模块。模块 0 正在存取时,可以启动模块 1;模块 1 正在存取时,可以启动模块 2。各模块的操作在时间上重叠,因此能提高连续访问时的吞吐率。
外部存储器
磁盘存储器
磁盘设备的组成与存储区域
磁盘设备的组成与存储区域
设备组成:
- 磁盘驱动器:驱动盘片旋转,并控制磁头在盘面上读写数据。
- 磁盘控制器:连接磁盘驱动器与主机,接收并解析 CPU 的命令,发送控制信号并监控运行状态。
- 盘片:真正保存数据的磁性存储介质。
磁盘地址与寻址顺序
磁盘地址与寻址顺序
磁盘地址通常由“柱面号、盘面号、扇区号”组成:
访问顺序通常为:
记录密度与容量
记录密度与容量
非格式化容量表示磁记录表面理论上可利用的磁化单元数量:格式化容量表示按扇区、地址和校验信息等格式组织后,实际可供用户使用的容量:
对低密度磁盘,各磁道扇区数相同,由于外圈周长更长,内圈位密度通常高于外圈。高密度磁盘则尽量使各磁道位密度接近,外圈可设置更多扇区,从而提高整盘容量。
磁盘存取时间的计算
磁盘存取时间的计算
磁盘的完整响应时间通常包括:磁盘存取时间通常只计算后三项:设磁盘转速为 转/分钟,则旋转一周的时间为:平均旋转等待时间约为旋转半周:平均存取时间一般写为:
RAID 各级对比
RAID 各级对比
RAID7 通常指带有实时操作系统和 Cache 的厂商增强型磁盘阵列,不是与 RAID0~RAID6 完全同维度的标准分级。复习时按指定教材口径掌握,不建议与前面各级只按“冗余方式”横向比较。
固态硬盘(SSD)
固态硬盘(SSD)
固态硬盘基于 Flash 等半导体存储介质,没有机械寻道和旋转等待。基本读写单位:
- 读操作以页为单位。
- 写操作以页为单位。
- 擦除操作以块为单位,通常一个块包含多个页。
Cache
Cache 的基本原理
Cache 行与数据块
Cache 行与数据块
Cache 以数据块为单位把主存中的连续数据调入高速缓存。主存和 Cache 之间以块为单位交换数据,CPU 与 Cache 之间通常以字或字节为单位访问。每一行通常需要:
Cache 利用程序局部性工作:命中时直接返回数据,未命中时再从主存调入数据块。
映射方式
直接映射
直接映射
主存中的每个块只能映射到唯一的 Cache 行:地址结构为:
- 查找时只需要比较一个标记,硬件简单、速度快。
- 映射位置固定,块冲突概率最高,空间利用率最低。
全相联映射
全相联映射
主存中的任意一个块都可以放入任意一个 Cache 行:
- 块冲突概率最低,Cache 空间利用率高。
- 需要同时比较所有行的标记,比较器数量多、硬件开销大。
组相联映射
组相联映射
Cache 先划分成若干组,主存块映射到唯一的一组,但可以放入该组中的任意一行:地址结构为:
若每组有 行,则称为 路组相联映射,它是直接映射和全相联映射的折中。
替换算法
写策略
写命中
写命中
写未命中
写未命中
容量与地址位数
Cache 总容量
Cache 总容量
Cache 数据区的行数可由容量和块大小确定:若题目要求计算包括目录信息在内的总容量,应把每行的数据位、标记位和控制位一起计入:
脏位只在回写策略中存在;替换信息不一定按行计算,可能按组或每种算法单独维护。LRU 位宽必须以教材或题目给出的实现为准,不能一律写成 。
地址字段计算
地址字段计算
设主存地址为 位,数据块大小为 字节,Cache 数据区大小为 字节。
- 块内地址位数:
- Cache 数据块总数与行数:
- 直接映射的 Cache 行号位数:
- 路组相联的组数为 ,组号位数为:
- 直接映射的标记位数:
- 组相联映射的标记位数:
- 全相联映射的标记位数:
地址划分示例
地址划分示例
某计算机主存地址为 32 位,Cache 数据区容量为 ,块大小为 ,采用四路组相联映射。
- 块内地址位数:,所以块内地址为 6 位。
- Cache 数据块数:。
- Cache 组数:,所以组号为 7 位。
- 标记位数: 位。
Cache 性能计算
命中率与平均访问时间
命中率与平均访问时间
设命中率为 ,命中时间为 ,未命中需要额外付出缺失代价 ,则:例如,Cache 命中时间为 1 个时钟周期,缺失代价为 100 个时钟周期,命中率为 95%,则:平均每次访问需要 6 个时钟周期。
虚拟存储器
页式虚拟存储器
分页与地址结构
分页与地址结构
虚拟存储器把程序划分成固定大小的页,把主存划分成同样大小的页框或物理页。页和页框大小相同,因此页内偏移在地址转换前后保持不变。
虚拟页号到物理页号的映射由页表保存。页表项通常还包含有效位、访问位、修改位、保护位等信息。
页内地址字段的位数由页大小决定。虚拟地址和物理地址的页内偏移相同,因此地址转换主要替换页号部分。
TLB 与地址转换过程
TLB 与地址转换过程
快表(TLB)是由高速 SRAM 构成的地址转换缓存,它缓存的是页表项,不是程序数据。一次访问大致经过以下步骤:
- CPU 用虚拟页号查询 TLB。
- TLB 命中时,直接获得物理页号,与页内地址拼接得到物理地址。
- TLB 未命中时,访问主存中的页表。
- 页表项有效时,把页表项填入 TLB,再完成地址转换。
- 页表项无效时产生缺页异常,由操作系统把页面调入主存,更新页表和 TLB,再重新执行相关指令。
TLB 与多级页表
TLB 与多级页表
若题目给出 TLB 命中率和主存访问时间,可按访问路径计算有效访问时间。不访问 Cache 时,设 TLB 查询时间为 ,一次主存访问时间为 ,TLB 命中率为 :其中 TLB 未命中时需要访问主存中的页表取得页表项,再访问主存取得目标数据。多级页表通过分级存储页表项,避免为整个虚拟地址空间准备一张连续大页表。二级页表的虚拟地址可以写成:
具体页号位数由虚拟地址位数、页大小和每级页表项数量共同决定。
段式与段页式虚拟存储器
段式虚拟存储器
段式虚拟存储器
段是按照程序的逻辑结构划分的可变长区域。由于段长度可变,段表项除了给出段基址,还必须给出段长,并在访问时进行越界检查。
段式管理便于按程序逻辑共享和保护,但会产生外部碎片。
段页式虚拟存储器
段页式虚拟存储器
段页式管理先把程序按逻辑划分成段,再把每个段划分成固定大小的页。地址转换过程通常为:
- 用段号查询段表,得到该段的页表起始地址。
- 用段内页号查询页表,得到物理页号。
- 将物理页号与页内地址拼接,得到物理地址。
公式与易错点速查
核心公式
核心公式
最易混淆的点
最易混淆的点
- SRAM 与 DRAM:SRAM 不需要刷新,DRAM 是破坏性读出并需要定时刷新。
- 字扩展与位扩展:字扩展增加存储单元数量,位扩展增加每个存储单元的数据位数。
- 连续编址与交叉编址:连续编址的高位是模块号,交叉编址的低位是模块号。
- RAID4 与 RAID5:RAID4 使用专用校验盘,RAID5 将校验块分散到各磁盘。
- 写分配与非写分配:写分配先把主存块调入 Cache,再写入;非写分配直接写主存。
- 全写与回写:全写法同时更新 Cache 和主存,回写法只更新 Cache 并依赖脏位。
- TLB 与 Cache:TLB 缓存地址转换信息,Cache 缓存程序数据。
- TLB 未命中与缺页:TLB 未命中只表示转换项不在 TLB 中;只有页不在主存时才是缺页。